SIEM, czyli Security Information and Event Management, to jedna z tych technologii, które robią największą różnicę wtedy, gdy organizacja przestaje patrzeć na każdy log osobno. W praktyce chodzi o centralne zbieranie zdarzeń z systemów, ich porządkowanie, łączenie w sensowny obraz i szybkie wychwytywanie anomalii. Poniżej wyjaśniam, jak to działa, czym SIEM różni się od SOAR i XDR oraz na co uważać przy wdrożeniu, żeby nie kupić drogich alertów bez realnej wartości.
Najkrócej mówiąc, SIEM łączy rozproszone sygnały bezpieczeństwa w jeden czytelny obraz
- zbiera logi z endpointów, serwerów, chmury, poczty i sieci,
- łączy pojedyncze zdarzenia w incydenty, zamiast zostawiać je w chaosie alertów,
- pomaga wykrywać phishing, nadużycia kont, ransomware i eksfiltrację danych,
- wspiera audyt oraz analizę powłamaniową, ale wymaga strojenia i procesu,
- sam nie zastąpi zespołu bezpieczeństwa ani procedur reagowania.
Czym SIEM jest, a czym nie jest
Najprościej ujmując, SIEM to platforma, która zbiera dane o bezpieczeństwie z wielu źródeł i zamienia je w informacje możliwe do użycia przez analityka. To nie jest zapora sieciowa, która blokuje ruch, ani antywirus, który usuwa malware. Jego zadaniem jest dać jedną wersję prawdy o tym, co dzieje się w infrastrukturze.
Ja patrzę na SIEM jak na warstwę łączącą trzy rzeczy: widoczność, korelację i reakcję. Pojedynczy alert o logowaniu z nietypowej lokalizacji może być przypadkiem. Taki sam alert połączony z resetem hasła, zmianą reguł poczty i masowym pobieraniem plików zaczyna wyglądać jak realny incydent. Właśnie tu SIEM przestaje być „narzędziem do logów”, a staje się centrum pracy SOC, czyli zespołu operacyjnego bezpieczeństwa.
W praktyce warto też zapamiętać ważne rozróżnienie: SOC to zespół ludzi, a SIEM to technologia, której ten zespół używa. To podobna różnica jak między biblioteką a bibliotekarzem. Jedno porządkuje dane, drugie nadaje im sens i podejmuje decyzje. Z tej perspektywy łatwiej zrozumieć, dlaczego sam zakup platformy nie rozwiązuje jeszcze problemu bezpieczeństwa.
Najważniejsze jest jednak to, skąd ten system bierze dane i jak z nich robi użyteczny obraz. Tu zaczyna się praktyka, a nie katalog marketingowych haseł.
Jak SIEM zbiera i łączy dane w jeden obraz ataku
Dobry SIEM nie działa na jednym rodzaju logów. Łączy dane z wielu miejsc, bo atak rzadko zostawia ślad tylko w jednym systemie. Właśnie dlatego sens ma dopiero wtedy, gdy widzi jednocześnie tożsamości, endpointy, serwery, aplikacje, chmurę, pocztę i ruch sieciowy.
- Zbieranie danych - system pobiera logi i zdarzenia z różnych źródeł, na przykład przez agentów, Syslog, API albo konektory do usług chmurowych.
- Normalizacja - różne formaty są zamieniane na wspólny model, żeby dało się je porównać i analizować bez ręcznej gimnastyki.
- Korelacja - pojedyncze sygnały są łączone w łańcuch zdarzeń, na przykład kilka nieudanych logowań, a potem udany dostęp i nietypowy eksport danych.
- Wzbogacanie kontekstu - SIEM może dodać informacje o zagrożeniach, krytyczności zasobu albo roli użytkownika. Dzięki temu alert staje się bardziej czytelny.
- Priorytetyzacja - zamiast setek małych ostrzeżeń system wskazuje te, które naprawdę wymagają reakcji.
To właśnie tu pojawia się największa wartość technologii tej klasy. Sam log zwykle niewiele mówi. Dopiero zestawienie go z innymi sygnałami pozwala zobaczyć wzorzec. Jeśli ktoś pyta mnie, dlaczego SIEM w ogóle istnieje, odpowiadam krótko: bo ataki są sekwencją zdarzeń, a nie jednym kliknięciem.
W nowoczesnych wdrożeniach pojawiają się też analityka behawioralna i elementy AI. To pomaga wychwytywać anomalie, ale nie wolno traktować tego jak magii. Modele nadal potrzebują sensownych danych wejściowych, a złe logi dają złe wnioski, nawet jeśli system wygląda nowocześnie.
Gdy już wiadomo, jak działa taki mechanizm, warto odróżnić go od narzędzi, z którymi najczęściej się go miesza. To oszczędza sporo rozczarowań na etapie zakupu.
SIEM, SOAR i XDR nie robią tego samego
W praktyce te skróty często pojawiają się obok siebie, ale nie oznaczają tego samego. Najlepiej widać to w prostym porównaniu.
| Narzędzie | Główna rola | Kiedy ma największy sens |
|---|---|---|
| SIEM | Zbiera i koreluje logi oraz alerty z wielu źródeł | Gdy potrzebujesz widoczności, audytu, analizy incydentów i centralnego monitoringu |
| SOAR | Automatyzuje reakcję i orkiestrację działań | Gdy masz już powtarzalne procesy i chcesz skrócić czas obsługi alertów |
| XDR | Łączy telemetrię z końcówek, poczty, tożsamości i sieci, zwykle w jednym ekosystemie | Gdy chcesz mocniejszej warstwy detekcji wokół konkretnych produktów i źródeł danych |
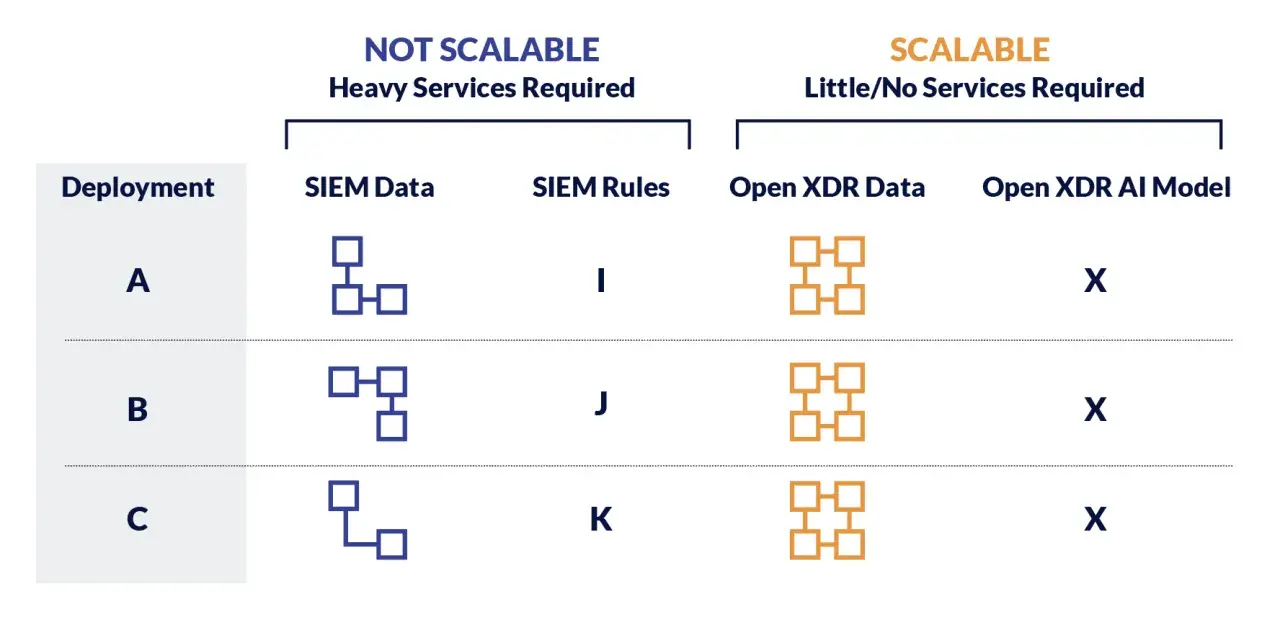
Najprościej mówiąc, SIEM daje szeroki obraz, SOAR usprawnia reakcję, a XDR wzmacnia wykrywanie w określonych obszarach. W dojrzałej organizacji te warstwy się uzupełniają, a nie wykluczają. To ważne, bo wiele osób oczekuje, że jedna platforma zrobi wszystko: wykryje, zareaguje, wyjaśni i jeszcze sama naprawi problem. Taki scenariusz brzmi dobrze na prezentacji, ale w realnym środowisku rzadko działa bez kompromisów.
Jeśli ktoś dopiero uczy się cyberbezpieczeństwa, ta różnica jest szczególnie cenna. Pokazuje, że bezpieczeństwo operacyjne to nie jeden produkt, tylko zestaw ról i procesów. I właśnie od tej praktycznej strony SIEM ma największą wartość.
Skoro narzędzia są już rozróżnione, zostaje najważniejsze pytanie: gdzie taki system naprawdę pomaga, a gdzie tylko robi wrażenie?
Gdzie SIEM daje największą wartość
SIEM najlepiej sprawdza się tam, gdzie trzeba połączyć wiele drobnych sygnałów w jeden czytelny incydent. W pojedynkę logi bywają mało znaczące, ale w serii potrafią pokazać cały przebieg ataku.
- Ataki na konta użytkowników - wiele nieudanych logowań, nietypowa lokalizacja, nagła zmiana urządzenia albo godziny pracy mogą wskazywać przejęcie konta.
- Phishing i poczta - SIEM może połączyć informację o podejrzanym mailu z próbą zalogowania, regułami przekierowania poczty i pobieraniem załącznika.
- Ransomware - nietypowe procesy, szybkie szyfrowanie plików, kontakt z podejrzaną domeną i ruch lateralny często zostawiają ślad w kilku źródłach naraz.
- Eksfiltracja danych - duży transfer w nietypowej porze, dostęp do rzadko używanych zasobów i nowe połączenia zewnętrzne mogą wskazywać wyciek.
- Audyt i zgodność - centralne logowanie ułatwia wykazanie, kto, kiedy i z jakiego systemu korzystał, co bywa ważne przy kontrolach i analizach wewnętrznych.
- Analiza powłamaniowa - po incydencie SIEM pomaga odtworzyć sekwencję zdarzeń, więc skraca czas dochodzenia do przyczyny.
Praktyczny przykład jest prosty: pojedynczy nieudany login nic nie znaczy. Dziesięć nieudanych logowań z różnych adresów, potem udane logowanie i pobranie dużej paczki plików już tak. Właśnie w takich ciągach zdarzeń SIEM pokazuje swoją przewagę nad ręcznym przeglądaniem logów.
Nie chodzi jednak tylko o wykrywanie ataków. Dobrze ustawiony system pomaga też zrozumieć zwykłe błędy operacyjne, na przykład niepoprawnie skonfigurowane reguły dostępu, nadmiarowe uprawnienia albo konta, których nikt nie używa, ale nadal mają szerokie prawa. To często ten sam mechanizm, który potem ujawnia prawdziwy incydent.
Właśnie dlatego SIEM bywa cenny również w środowiskach edukacyjnych i laboratoryjnych. Uczy myślenia o bezpieczeństwie nie jako o pojedynczym alercie, ale jako o łańcuchu przyczyn i skutków. A to prowadzi do następnego problemu: co najczęściej psuje wdrożenie.
Najczęstsze błędy przy wdrożeniu
SIEM rzadko zawodzi dlatego, że sam pomysł jest zły. Zwykle problemem jest sposób użycia. Widziałem wdrożenia, które miały świetną technologię, ale praktycznie nikt z niej nie korzystał, bo alertów było za dużo, a sensu za mało.
- Zbieranie wszystkiego od razu - to prosta droga do wysokich kosztów i szumu informacyjnego. Lepiej zacząć od krytycznych źródeł.
- Brak use case’ów - jeśli nie wiesz, jakie 3-5 scenariuszy chcesz wykrywać, platforma zamienia się w magazyn danych.
- Słaba jakość logów - brak normalizacji, niespójne strefy czasowe i niepełne pola utrudniają korelację.
- Brak właściciela alertów - alarm, którego nikt nie analizuje w określonym czasie, traci wartość.
- Za szybka automatyzacja - automatyczne blokowanie kont bez walidacji potrafi wyrządzić więcej szkody niż pożytku.
- Brak strojenia reguł - bez regularnego dostrajania fałszywe pozytywy zaczynają dominować i analitycy przestają ufać systemowi.
Najgroźniejszy błąd jest zwykle prosty: organizacja kupuje platformę, ale nie buduje wokół niej procesu. A SIEM bez procesu to tylko kosztowny katalog logów. Żeby działał, potrzebuje jasnych reguł triage, retencji danych, odpowiedzialności i przynajmniej kilku dobrze zdefiniowanych scenariuszy wykrywania.
Jest jeszcze jeden praktyczny problem, o którym mało kto mówi na początku: koszty. Nie zawsze chodzi o licencję. Często drożeje dopiero to, co pod spodem, czyli wolumen danych, czas przechowywania i nakład pracy zespołu. I właśnie dlatego warto wybrać rozwiązanie rozsądnie, a nie efektownie.
Jak wybrać rozwiązanie, które nie przytłoczy zespołu
Przy wyborze SIEM patrzę przede wszystkim na użyteczność operacyjną, a dopiero potem na listę funkcji. W praktyce liczy się nie to, ile checkboxów odhacza producent, tylko czy zespół potrafi z tego korzystać każdego dnia.
| Kryterium | Na co patrzeć | Dlaczego to ważne |
|---|---|---|
| Źródła danych | Czy system obsługuje Twoje najważniejsze logi natywnie, przez API, Syslog lub konektory | Bez danych z tożsamości, endpointów i chmury wykrywanie będzie niepełne |
| Korelacja i reguły | Czy da się łatwo budować, testować i stroić reguły wykrywania | To decyduje o jakości alertów i liczbie fałszywych alarmów |
| Retencja | Czy możesz trzymać dane w warstwie operacyjnej i archiwalnej przez tyle czasu, ile naprawdę potrzebujesz | W wielu organizacjach sensowny zakres to krótsza retencja operacyjna 30-90 dni i dłuższe archiwum 6-12 miesięcy, jeśli wymaga tego audyt |
| Automatyzacja | Czy da się podłączyć ticketing, pocztę, komunikator i proste playbooki reakcji | To skraca czas odpowiedzi i zmniejsza ręczną pracę |
| Koszt operacyjny | Jak rośnie cena wraz z wolumenem logów, liczbą integracji i czasem retencji | To najczęstsze miejsce, w którym budżet „rozjeżdża się” po kilku miesiącach |
Gdybym miał doradzić prostą strategię startu, wybrałbym trzy rzeczy: 3 najważniejsze scenariusze wykrywania, 5 krytycznych źródeł logów i jeden jasny proces reakcji na alert. Dopiero potem rozbudowywałbym całość o kolejne integracje. Taki model jest nudniejszy od wielkiej wizji, ale zwykle działa lepiej.
W praktyce najlepszy SIEM to nie ten, który zbiera najwięcej danych, tylko ten, który daje zespołowi odpowiedzi na pytania naprawdę istotne dla bezpieczeństwa. Jeśli odpowiedzi są czytelne, system zaczyna bronić organizacji. Jeśli nie, staje się tylko kolejną warstwą technologii do utrzymania.
Co warto ustalić przed pierwszym wdrożeniem
Zanim uruchomisz platformę albo zaczniesz ją oceniać, warto odpowiedzieć sobie na kilka prostych pytań. To oszczędza czas, budżet i sporo frustracji.
- Jakie incydenty chcę wykrywać w pierwszej kolejności - przejęcie konta, ransomware, wyciek danych czy nadużycia administracyjne.
- Jakie źródła logów są krytyczne - tożsamość, poczta, endpointy, firewall, VPN, chmura, serwery aplikacyjne.
- Kto analizuje alerty i w jakim czasie - bez właściciela nawet dobry alert szybko traci wartość.
- Jak długo trzymam dane - osobno dla pracy operacyjnej i dla archiwum lub audytu.
- Co zrobię po wykryciu incydentu - izolacja hosta, reset konta, blokada reguły pocztowej, eskalacja do zespołu.
Jeśli te odpowiedzi są jasne, SIEM zaczyna mieć sens jako narzędzie bezpieczeństwa, a nie jako efektowny zakup. Jeśli nie są jasne, lepiej zacząć od porządkowania logów, definicji użycia i kilku dobrze dobranych reguł niż od dużej platformy, która robi wrażenie tylko na slajdzie. Dobrze wdrożony system ma pomagać widzieć więcej i reagować szybciej, a nie zasypać zespół kolejnymi sygnałami bez znaczenia.